MY BOOK
안쪽까지 들여다보는 스프링 시큐리티
책 보러 가기
데이터베이스는 볼륨이 커질수록 읽기/쓰기 성능이 감소한다. 성능 향상을 위해 데이터를 분할하여 저장하는 파티셔닝(partitioning) 혹은 샤딩(sharding)이라는 기법을 사용한다. 이번 글에서는 파티셔닝 개념을 정리하였다.
파티션(partition)은 테이블을 논리적으로는 하나이지만, 물리적으로는 여러 개로 분리하여 관리하는 데이터베이스의 기능
데이터를 여러 개의 테이블로 분리하여 관리하는 파티션 기법을 적용하는 것을 파티셔닝(partitioning)이라고 한다. 대용량 테이블을 물리적으로 여러 개의 소규모 테이블로 분산하는 목적으로 주로 사용한다. 물리적인 데이터 분할이 있더라도 데이터베이스에 접근하는 애플리케이션 입장에선 이를 인지하지 못한다.
파티션을 사용하는 이유를 살펴보자. 우선 테이블이 너무 커서 인덱스의 크기가 물리적인 메모리보다 훨씬 큰 경우 파티셔닝을 고려한다.
INSERT, UPDATE, DELETE, SELECT 작업도 함께 느려진다.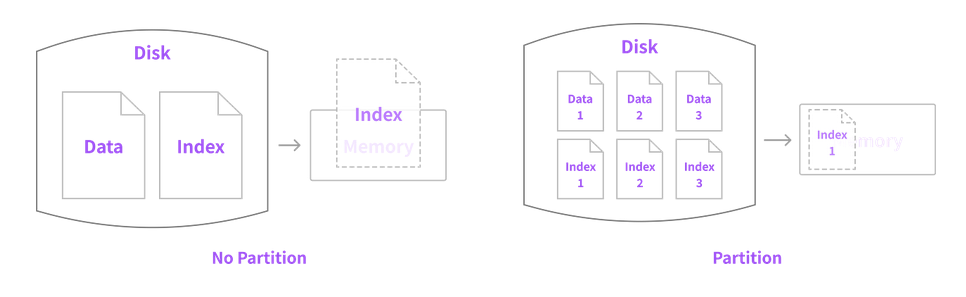
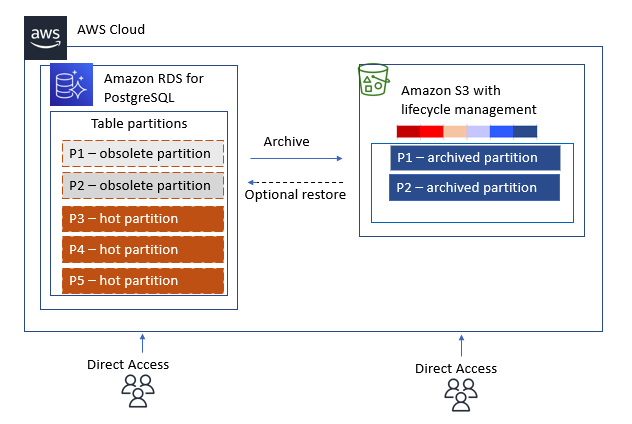
데이터 특성상 주기적으로 삭제 작업이 필요한 경우에도 파티셔닝이 필요하다. 단기간에 대량으로 누적되고 일정 기간이 지나면 쓸모가 없어지는 로그 성격의 이력 데이터를 예로 들 수 있다. 이런 타입의 데이터는 시간이 지나면 별도로 아카이빙(archiving)하거나 백업한 후 삭제한다.
불필요해진 데이터를 백업하거나 삭제하는 작업은 일반 테이블에서는 상당히 고부하 작업이므로 미리 파티셔닝을 통해 데이터를 작업 단위로 나눠두고 편리하게 작업한다.
파티션 기법은 다음과 같은 장점을 제공한다.
다음과 같은 단점도 존재한다.
파티셔닝 방법은 크게 두 가지로 구분된다. 먼저 수평 파티셔닝(Horizontal Partitioning)을 살펴보자. 데이터를 행 단위로 분할하는 방법이다. 일반적으로 분산 저장 기술에서 파티셔닝은 수평 분할을 의미한다.
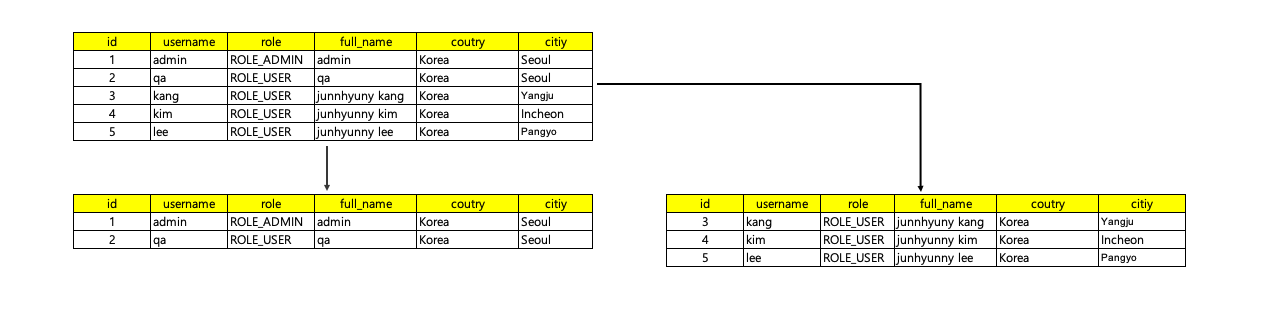
다음으로 수직 파티셔닝(Vertical Partitioning)을 알아보자. 데이터를 열 단위로 분할한다.
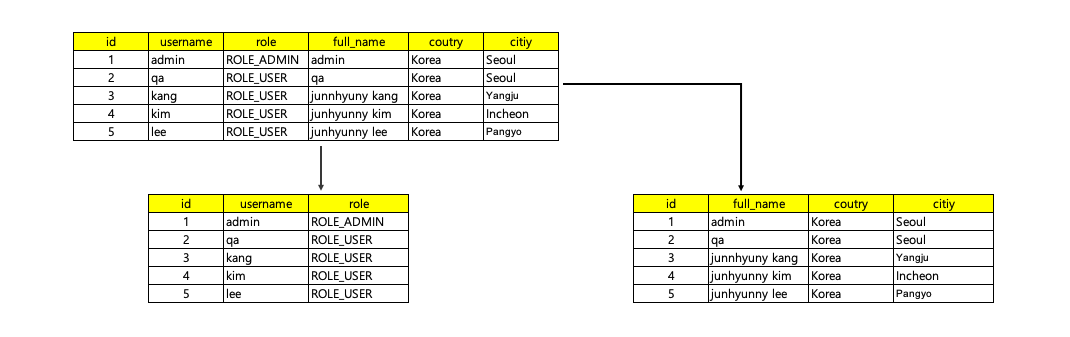
MySQL을 기준으로 보면 4가지 기본 파티션 기법이 존재한다.
레인지 파티션은 다음과 같은 용도에 사용하는 것이 적합하다.
mysql> CREATE TABLE employees (
    id INT NOT NULL AUTO_INCREMENT,
    first_name VARCHAR(30),
    last_name VARCHAR(30),
    hired DATE NOT NULL DEFAULT '1970-01-01',
    primary key (id, hired)
) PARTITION BY RANGE(YEAR(hired)) (
    PARTITION p0 VALUES LESS THAN (1991),
    PARTITION p1 VALUES LESS THAN (2001),
    PARTITION p2 VALUES LESS THAN MAXVALUE
);

mysql> insert employees (first_name, last_name, hired)
values ('junhyunny', 'kang', '1990-08-15'),
       ('junhyunny', 'kim', '1995-06-06'),
       ('junhyunny', 'lee', '2005-06-06');

mysql> SELECT * FROM employees PARTITION (p0);
+----+------------+-----------+------------+
| id | first_name | last_name | hired      |
+----+------------+-----------+------------+
|  1 | junhyunny  | kang      | 1990-08-15 |
+----+------------+-----------+------------+

mysql> SELECT * FROM employees PARTITION (p1);
+----+------------+-----------+------------+
| id | first_name | last_name | hired      |
+----+------------+-----------+------------+
|  2 | junhyunny  | kim       | 1995-06-06 |
+----+------------+-----------+------------+

mysql> SELECT * FROM employees PARTITION (p2);
+----+------------+-----------+------------+
| id | first_name | last_name | hired      |
+----+------------+-----------+------------+
|  3 | junhyunny  | lee       | 2005-06-06 |
+----+------------+-----------+------------+
리스트 파티션은 다음과 같은 용도에 사용하는 것이 적합하다.
mysql> CREATE TABLE product (
    id INT NOT NULL AUTO_INCREMENT,
    name VARCHAR(30),
    category_id VARCHAR(30) NOT NULL,
    primary key (id, category_id)
) PARTITION BY LIST COLUMNS (category_id) (
    PARTITION p_appliance VALUES IN ('TV'),
    PARTITION p_computer VALUES IN ('Labtop', 'Desktop'),
    PARTITION p_sports VALUES IN ('Tennis', 'Soccer', NULL)
);

mysql> insert product (name, category_id)
values ('LG TV', 'TV'),
       ('MacBook Pro', 'Labtop'),
       ('Dell Desktop', 'Desktop'),
       ('Fila Shoes', 'Tennis'),
       ('Nike Shoes', 'Soccer');

mysql> SELECT * FROM product PARTITION (p_appliance);
+----+-------+-------------+
| id | name  | category_id |
+----+-------+-------------+
|  6 | LG TV | TV          |
+----+-------+-------------+

mysql> SELECT * FROM product PARTITION (p_computer);
+----+--------------+-------------+
| id | name         | category_id |
+----+--------------+-------------+
|  7 | MacBook Pro  | Labtop      |
|  8 | Dell Desktop | Desktop     |
+----+--------------+-------------+

mysql> SELECT * FROM product PARTITION (p_sports);
+----+------------+-------------+
| id | name       | category_id |
+----+------------+-------------+
|  9 | Fila Shoes | Tennis      |
| 10 | Nike Shoes | Soccer      |
+----+------------+-------------+
MySQL에서 정의한 해시 함수에 의해 레코드(record)가 저장될 때 파티션을 결정하는 방법이다. 파티션 표현식의 결과 값을 파티션 개수로 나눈 나머지로 저장될 파티션을 결정한다. 해시 파티션의 파티션 키는 항상 정수 타입이거나 정수 타입을 반환하는 표현식만 사용 가능하다.
해시 파티션은 다음과 같은 용도에 사용하는 것이 적합하다.
-- 파티션 개수를 지정하면 각 파티션의 이름은 기본적으로 p0, p1, p2 ... 같은 규칙으로 생성됩니다.
mysql> CREATE TABLE employees (
    id INT NOT NULL AUTO_INCREMENT,
    first_name VARCHAR(30),
    last_name VARCHAR(30),
    hired DATE NOT NULL DEFAULT '1970-01-01',
    primary key (id)
) PARTITION BY HASH(id) PARTITIONS 4;

mysql> insert employees (first_name, last_name, hired)
values ('junhyunny', 'kang', '1990-08-15'),
       ('junhyunny', 'kim', '1995-06-06'),
       ('junhyunny', 'lee', '2005-06-06');

mysql> SELECT * FROM employees PARTITION (p0);

mysql> SELECT * FROM employees PARTITION (p1);
+----+------------+-----------+------------+
| id | first_name | last_name | hired      |
+----+------------+-----------+------------+
|  1 | junhyunny  | kang      | 1990-08-15 |
+----+------------+-----------+------------+
1 row in set (0.00 sec)

mysql> SELECT * FROM employees PARTITION (p2);
+----+------------+-----------+------------+
| id | first_name | last_name | hired      |
+----+------------+-----------+------------+
|  2 | junhyunny  | kim       | 1995-06-06 |
+----+------------+-----------+------------+

mysql> SELECT * FROM employees PARTITION (p3);
+----+------------+-----------+------------+
| id | first_name | last_name | hired      |
+----+------------+-----------+------------+
|  3 | junhyunny  | lee       | 2005-06-06 |
+----+------------+-----------+------------+
키 파티션은 사용법과 특성이 해시 파티션과 같다. 해시 파티션은 해시 값을 계산하여 사용하지만, 키 파티션은 사용자가 명시한다. 최종적으로 MySQL 서버가 그 값을 MOD 연산을 수행하여 파티션을 결정한다.
해시 파티션과는 다음과 같은 차이점이 있다.
MySQL 서버가 내부적으로 MD5() 함수를 이용해 파티션하기 때문에 파티션 키가 반드시 정수 타입이 아니어도 된다.mysql> CREATE TABLE department_employees(
department_no CHAR(4) NOT NULL,
employee_no INT NOT NULL,
department_name VARCHAR(30),
employee_name VARCHAR(30),
PRIMARY KEY (department_no, employee_no)
) PARTITION BY KEY(department_no) PARTITIONS 2;
mysql> insert department_employees (department_no, employee_no, department_name, employee_name)
values (1, 1, 'Marketing', 'Junhyunny Kang'),
(2, 2, 'Development', 'Junhyunny Kim'),
(3, 3, 'Design', 'Junhyunny Lee'),
(4, 4, 'Plan', 'Junhyunny Jung'),
(1, 5, 'Marketing', 'Junhyunny Bang'),
(2, 6, 'Development', 'Junhyunny Oh'),
(3, 7, 'Design', 'Junhyunny Choen');
mysql> SELECT * FROM department_employees PARTITION (p0);
+---------------+-------------+-----------------+----------------+
| department_no | employee_no | department_name | employee_name |
+---------------+-------------+-----------------+----------------+
| 2 | 2 | Development | Junhyunny Kim |
| 2 | 6 | Development | Junhyunny Oh |
| 4 | 4 | Plan | Junhyunny Jung |
+---------------+-------------+-----------------+----------------+
mysql> SELECT * FROM department_employees PARTITION (p1);
+---------------+-------------+-----------------+-----------------+
| department_no | employee_no | department_name | employee_name |
+---------------+-------------+-----------------+-----------------+
| 1 | 1 | Marketing | Junhyunny Kang |
| 1 | 5 | Marketing | Junhyunny Bang |
| 3 | 3 | Design | Junhyunny Lee |
| 3 | 7 | Design | Junhyunny Choen |
+---------------+-------------+-----------------+-----------------+
댓글남기기